Visión por computador · 2026
Estudio de ablación en MNIST y CIFAR-10: 99,47 % y 93,87 % de exactitud
Dos estudios de ablación que miden cuánto aporta cada pieza hasta superar el 99,4 % en MNIST sin convoluciones y el 92 % en CIFAR-10.
- en MNIST solo con perceptrones, sin convoluciones
- 99,47 %
- en CIFAR-10 con una DenseNet-100 propia
- 93,87 %
- sobre la línea base en CIFAR-10
- +11,7 pts
- configuraciones comparadas en dos ablaciones
- 11
Problema
MNIST y CIFAR-10 son los dos bancos de pruebas clásicos de clasificación de imágenes. Aquí el reto no era solo llegar a una cifra, sino saber qué la produce: partir de un modelo sencillo, proponer mejoras y medir por separado la contribución de cada una.
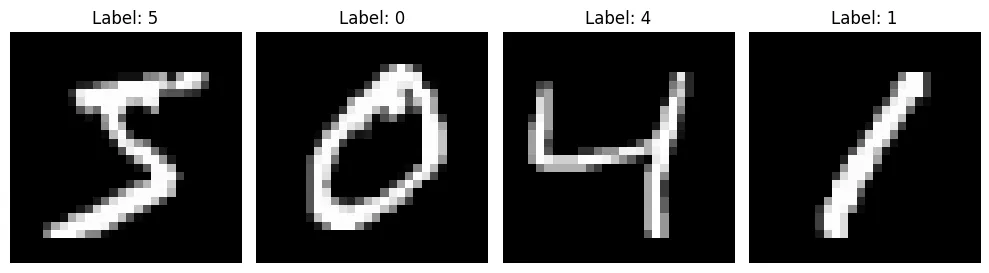
- MNIST (dígitos manuscritos de 28 × 28, 60.000 de entrenamiento y 10.000 de test): superar el 99,4 % de exactitud sin capas convolucionales, solo con perceptrones multicapa (MLP).
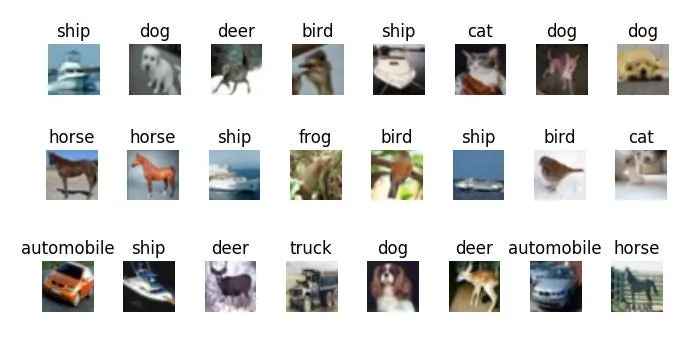
- CIFAR-10 (imágenes en color de 32 × 32 de 10 clases, 50.000 y 10.000): superar el 92 %.
 Ver imagen ampliada
 Ver imagen ampliada
Mi contribución
Proyecto individual: diseñé las arquitecturas y los pipelines de aumento de datos, los implementé en PyTorch, ejecuté los 11 experimentos (100 épocas cada uno) y documenté cada estudio en una memoria técnica.
Enfoque técnico
MNIST: un MLP que se comporta como una red moderna
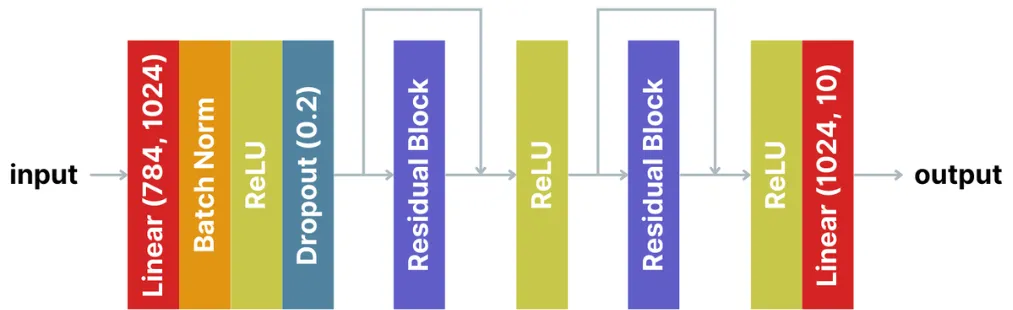
La línea base es un MLP de cuatro capas lineales (784 → 1024 → 1024 → 1024 → 10) con ReLU. Sobre él propuse dos cambios independientes:
- Arquitectura (modelo B): normalización por lotes, dropout del 20 % y dos bloques residuales de 1024 neuronas, como los de una ResNet pero con capas lineales.
- Aumento de datos: rotaciones suaves (±10°, para no confundir 6 y 9), traslaciones y escalados del 10 %, deformaciones elásticas, que imitan la variación natural de la escritura, y ruido gaussiano.
 Ver imagen ampliada
CIFAR-10: tres arquitecturas, aumento de datos y planificador
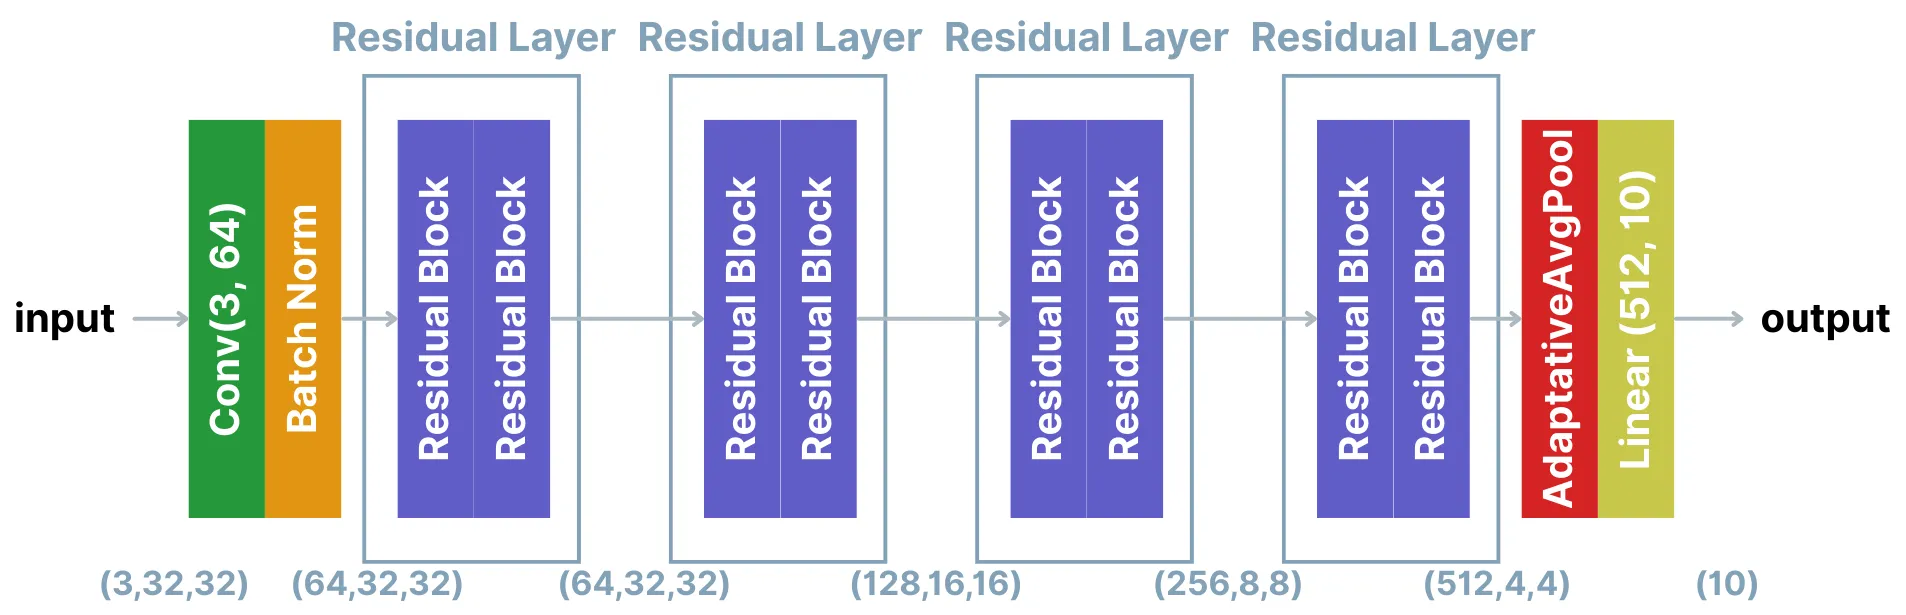
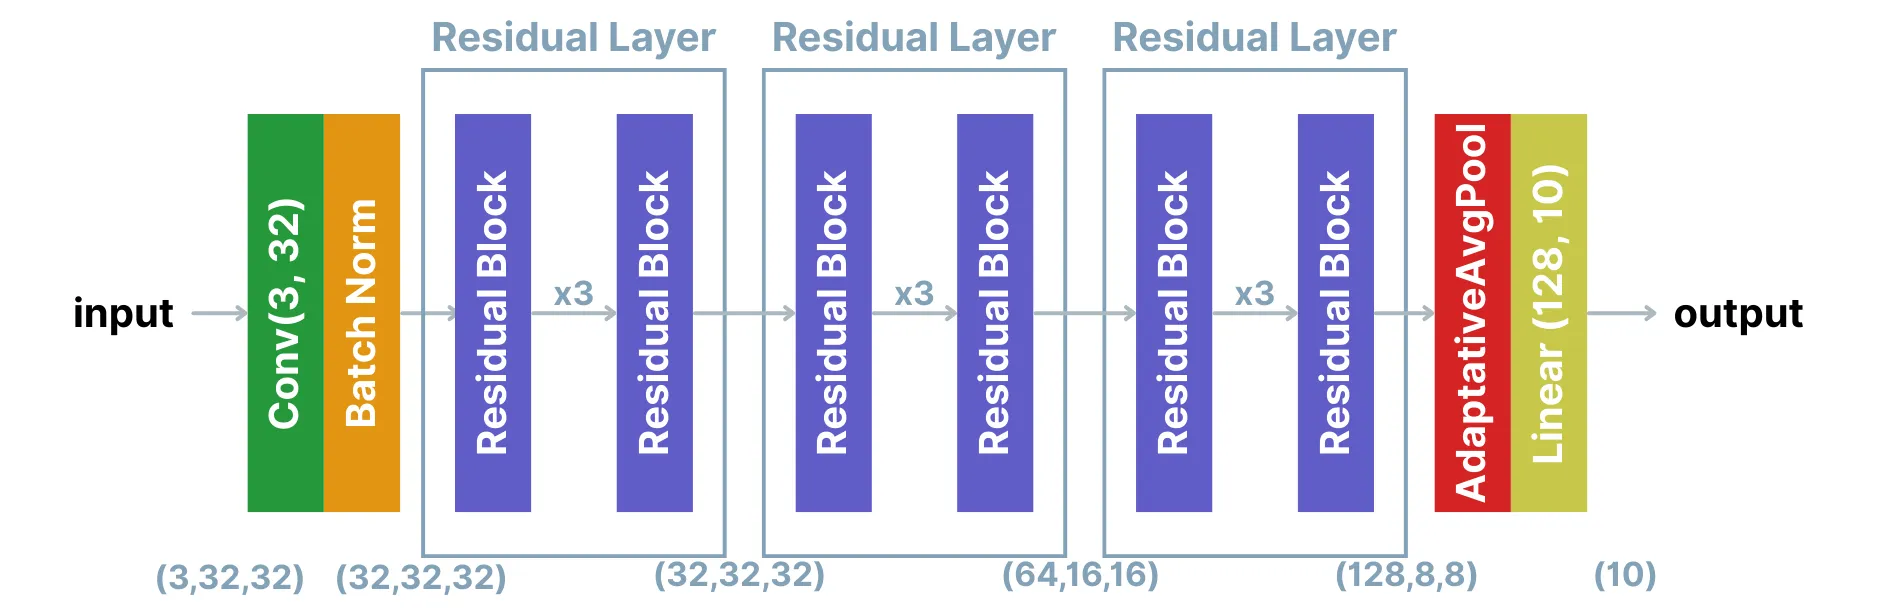
La línea base es una CNN sencilla de cinco bloques convolucionales (32 → 512 canales) sin aumento de datos. Comparé tres arquitecturas implementadas desde cero y dos mejoras de entrenamiento:
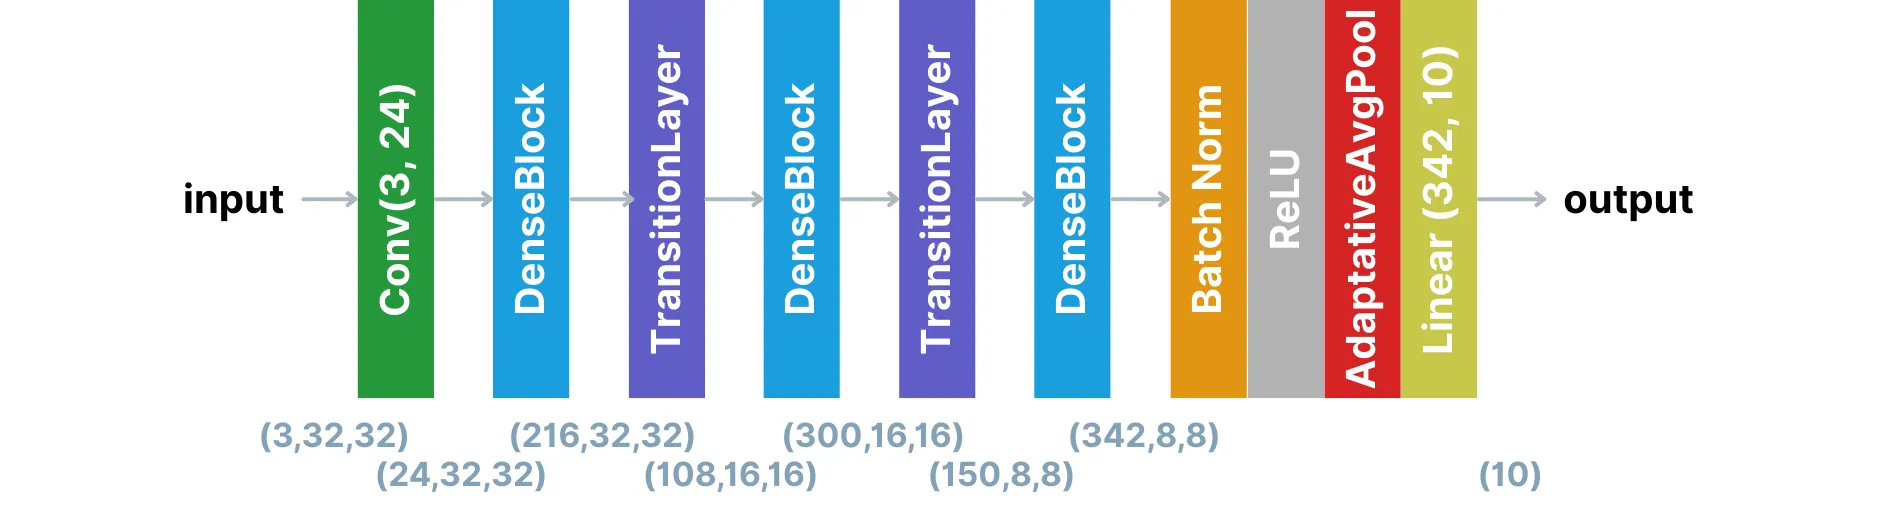
- ResNet-18, WideResNet-32 (más ancha y menos profunda) y DenseNet-100: tres bloques densos de 16 capas en los que cada capa recibe las salidas de todas las anteriores.
- Aumento de datos: recortes aleatorios con relleno de 4 px, volteo horizontal y random erasing, que tapa zonas de la imagen para que el modelo no dependa de un solo detalle.
- Entrenamiento: planificador coseno de la tasa de aprendizaje y más weight decay (5 × 10⁻⁴).
 Ver imagen ampliada
 Ver imagen ampliada
 Ver imagen ampliada
La pieza clave de DenseNet es la capa densa: en lugar de sumar la entrada como una ResNet, la concatena, de modo que cada capa reutiliza todas las características anteriores con muy pocos parámetros nuevos.
# CIFAR/CIFAR.ipynb — capa densa (growth_rate = 12)
class DenseLayer(nn.Module):
    def __init__(self, in_channels, growth_rate):
        super().__init__()
        self.bn = nn.BatchNorm2d(in_channels)
        self.relu = nn.ReLU(inplace=True)
        self.conv = nn.Conv2d(in_channels, growth_rate,
                              kernel_size=3, padding=1, bias=False)

    def forward(self, x):
        out = self.conv(self.relu(self.bn(x)))
        # Concatena en lugar de sumar: cada capa ve todas las anteriores
        return torch.cat([x, out], dim=1)
Resultados
- Línea base98,31 %
- Modelo B98,83 %
- Aumento de datos99,40 %
- Modelo B + aumento de datos99,47 %
Escala de 98,0 % a 99,5 %
En MNIST, el aumento de datos pesa más que la arquitectura: por sí solo ya alcanza el objetivo (99,40 %), mientras que el modelo B aporta medio punto. Combinados llegan al 99,47 %. Parece poco, pero el número de errores en test baja de 169 a 53 imágenes: tres veces menos.
- Línea base (CNN sencilla)82,20 %
- ResNet-1885,45 %
- WideResNet-3286,45 %
- DenseNet-10089,40 %
- CNN + aumento de datos87,82 %
- CNN + planificador coseno82,53 %
- DenseNet-100 + aumento de datos + planificador93,87 %
Escala de 80 % a 95 %
En CIFAR-10, en cambio, la arquitectura es lo que más aporta: DenseNet-100 gana 7,2 puntos con 1,05 M de parámetros, menos que la CNN base (1,84 M) y diez veces menos que ResNet-18 (11,2 M), que se queda en el 85,45 %. El aumento de datos suma 5,6 puntos a la CNN base; el planificador, solo 0,3 por sí solo. Todo junto alcanza el 93,87 %, casi dos puntos por encima del objetivo.
Evidencias
- Repositorio con los notebooks del modelo final y de la ablación de cada conjunto, con todas las salidas de entrenamiento.
- Memorias técnicas: MNIST y CIFAR-10.
Aplicación profesional
- Mejorar un modelo con pasos medibles en lugar de por prueba y error: saber qué componente compensa antes de invertir más cómputo o más datos.
- Elegir arquitecturas eficientes cuando importan el tamaño o el coste de inferencia: aquí, el mejor modelo es también uno de los más pequeños.
- Diseñar aumentos de datos adaptados al dominio, que por sí solos dieron el mayor salto en MNIST y más de cinco puntos en CIFAR-10.
Otros proyectos
Ver todos los proyectos
Imagen médica
Clasificación multietiqueta de radiografías de tórax con DenseNet-121
Detección de 14 patologías a la vez en 112.000 radiografías de tórax, con pérdida asimétrica, umbrales calibrados por patología y Grad-CAM++ para auditar el modelo.
Imagen médica
Segmentación de melanoma con U-Net implementadas desde cero en PyTorch
Dos U-Net programadas desde cero para delimitar lesiones de piel: una entrenada desde cero y otra con un codificador ResNet-50 preentrenado y congelado.