Imagen médica · 2026
Clasificación multietiqueta de radiografías de tórax con DenseNet-121
Detección de 14 patologías a la vez en 112.000 radiografías de tórax, con pérdida asimétrica, umbrales calibrados por patología y Grad-CAM++ para auditar el modelo.
- AUC-ROC macro en test
- 0,83
- patologías evaluadas a la vez en cada imagen
- 14
- radiografías de ChestMNIST
- 112.120
- AUC sobre la ResNet-50 de referencia de MedMNIST v2
- +0,06
Problema
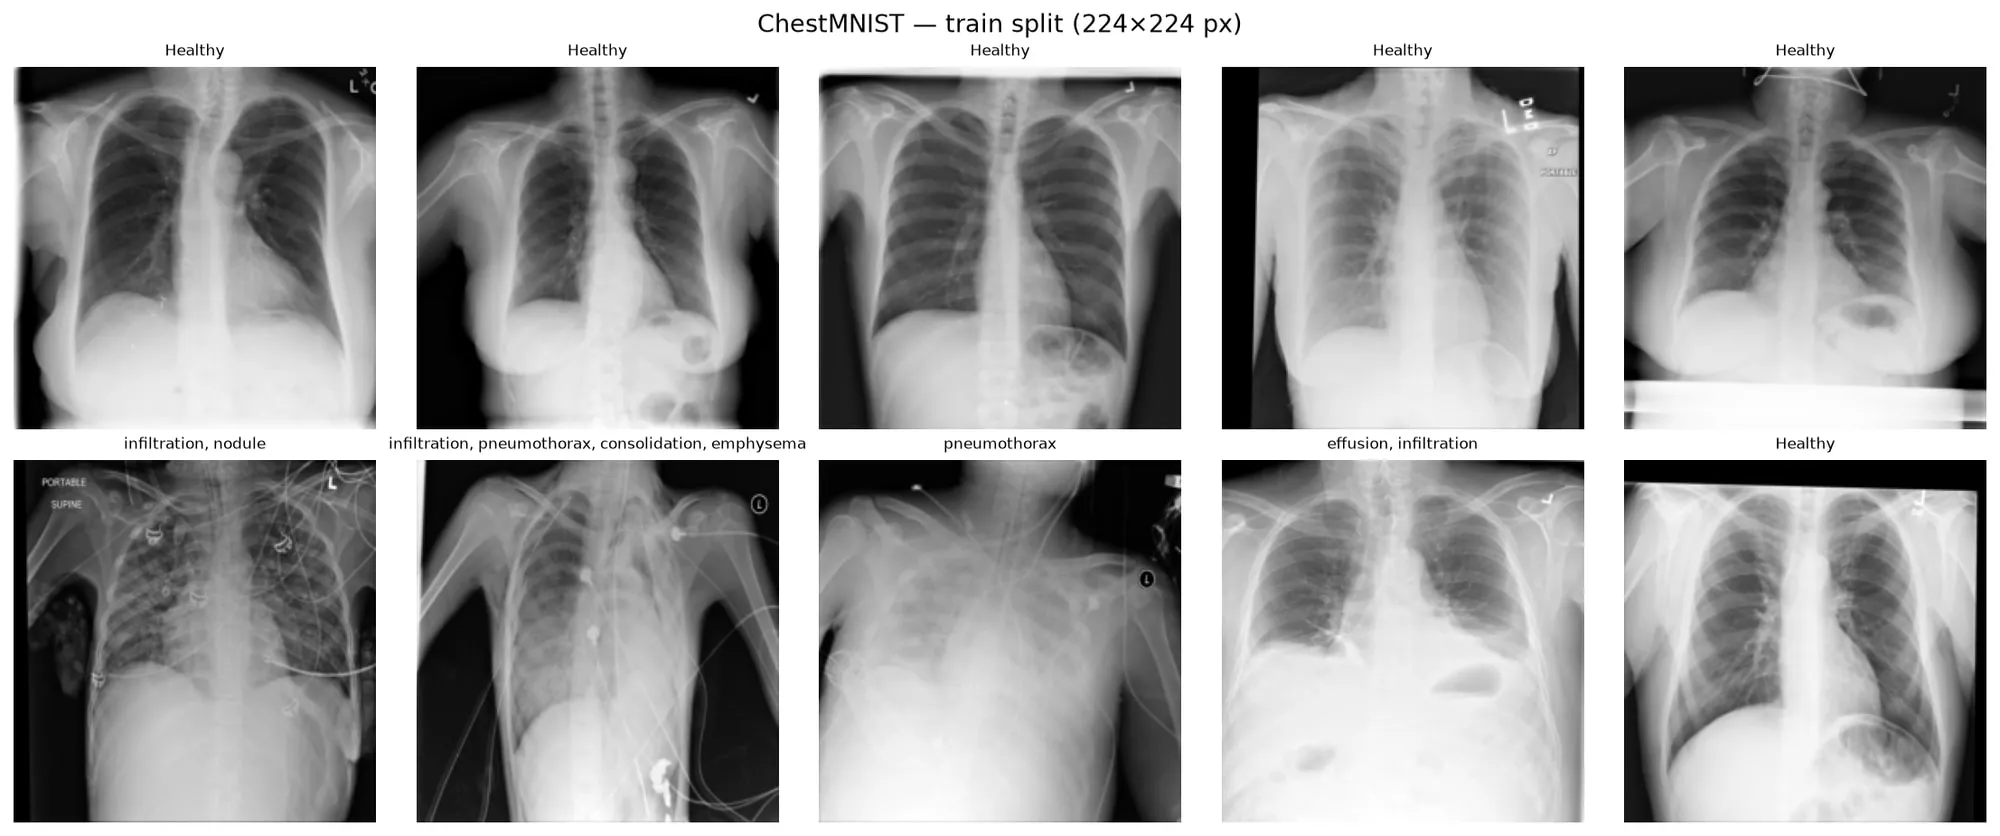
Una radiografía de tórax puede mostrar varias patologías a la vez, o ninguna. ChestMNIST, derivado de NIH ChestX-ray14, reúne 112.120 radiografías etiquetadas con 14 patologías: atelectasia, cardiomegalia, derrame, infiltración, masa, nódulo, neumonía, neumotórax, consolidación, edema, enfisema, fibrosis, engrosamiento pleural y hernia. Es un problema multietiqueta: para cada imagen, el modelo decide por separado si cada patología está presente.
 Ver imagen ampliada
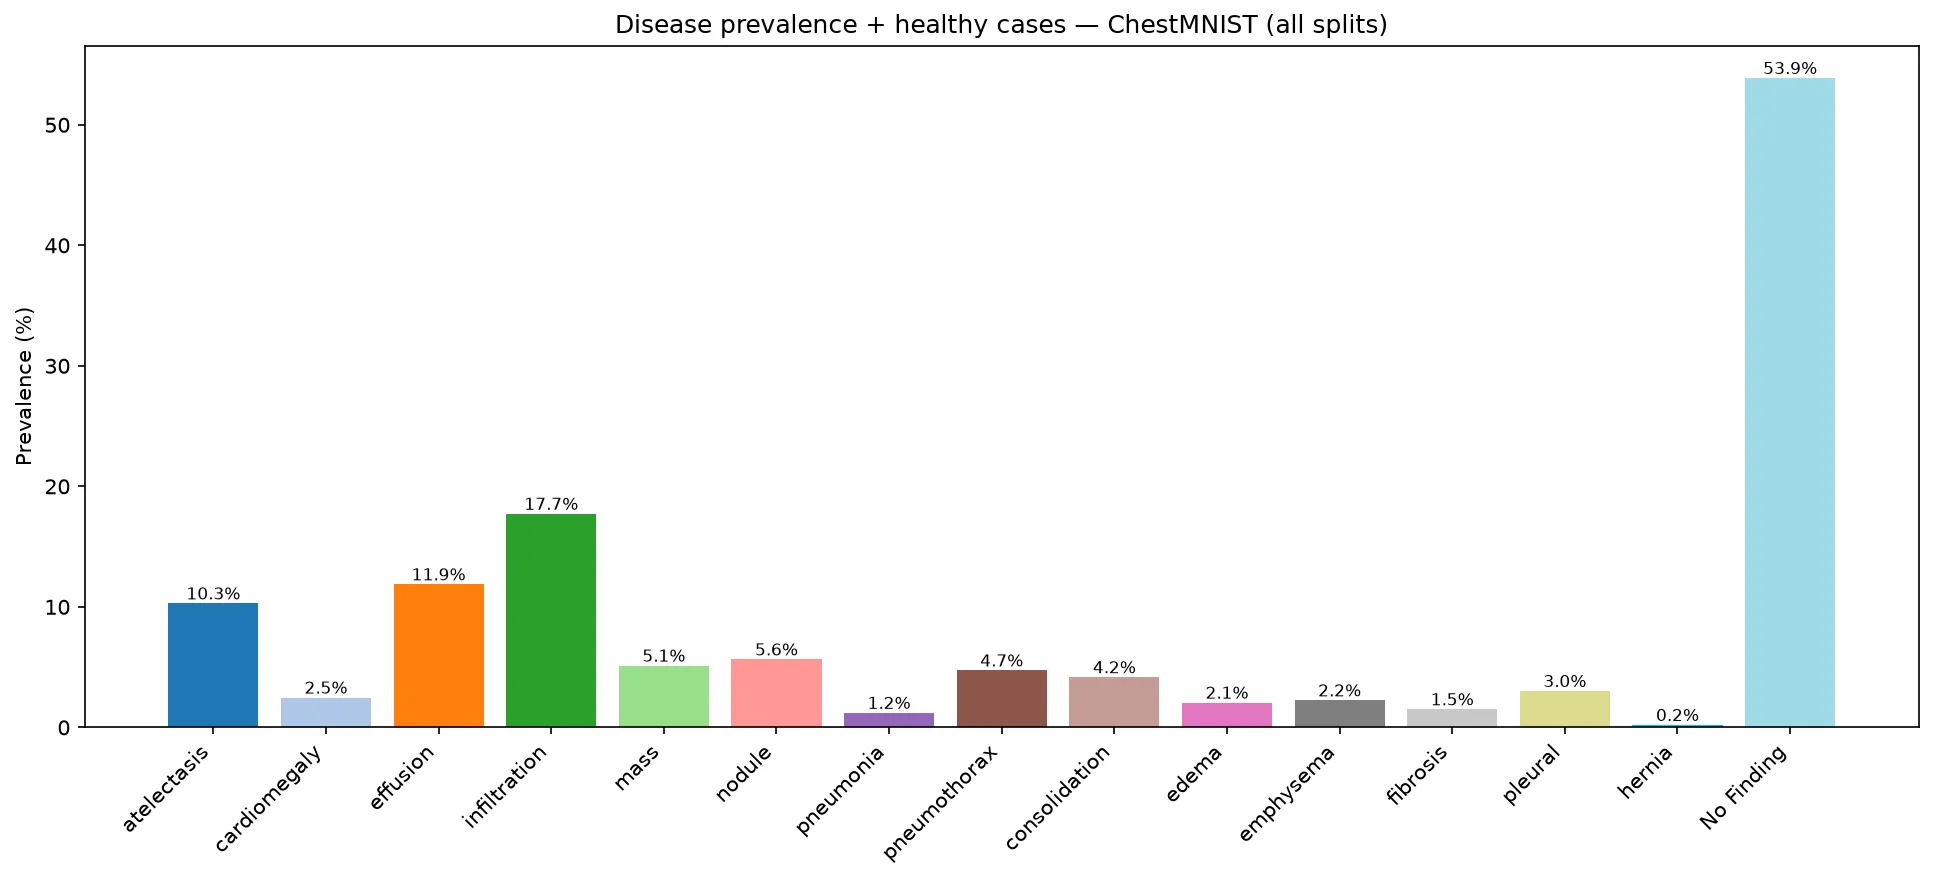
La dificultad está en el desbalance. El 53,9 % de las imágenes no tiene ningún hallazgo y algunas clases son muy raras (hernia: 0,2 %). Un modelo que responda siempre «sano» acierta más del 90 % de las etiquetas y no detecta nada. Por eso la exactitud no sirve como métrica principal y el trabajo se evalúa con AUC-ROC, F1 y precisión equilibrada.
 Ver imagen ampliada
Mi contribución
Proyecto individual para la asignatura Aplicaciones de Reconocimiento de Formas y Aprendizaje Automático:
- Análisis exploratorio: distribución de etiquetas, número de patologías por imagen y efecto de la resolución.
- Estudio experimental en el que cambio un factor cada vez: resolución, función de pérdida, arquitectura, aumento de datos y ajuste fino frente a codificador congelado.
- Pipeline final empaquetado en Python, con una etapa por módulo, rutas relativas a la raíz del proyecto, logs con marca de tiempo y dependencias fijadas.
- Calibración de umbrales por patología y explicabilidad con Grad-CAM++.
Enfoque técnico
La línea base es una ResNet-50 preentrenada en ImageNet con ajuste fino completo, BCE y entrada de 224 px. A partir de ahí comparé cada decisión por separado y me quedé con lo que funcionaba:
- Resolución: 224 px supera a 128 px (+0,018 de AUC). Los hallazgos pequeños, como nódulos, necesitan detalle.
- Pérdida: la Asymmetric Loss (ASL) da más peso a los positivos y reduce el de los negativos fáciles, que son la inmensa mayoría.
- Arquitectura: DenseNet-121, la misma familia que CheXNet, rinde algo mejor que ResNet-50.
- Aumento de datos: rotaciones, traslaciones y volteo horizontal con MONAI. Es el cambio individual con más efecto.
- Ajuste fino: congelar el codificador hunde la AUC a 0,74. Las características de ImageNet no bastan; hay que adaptar toda la red a las radiografías.
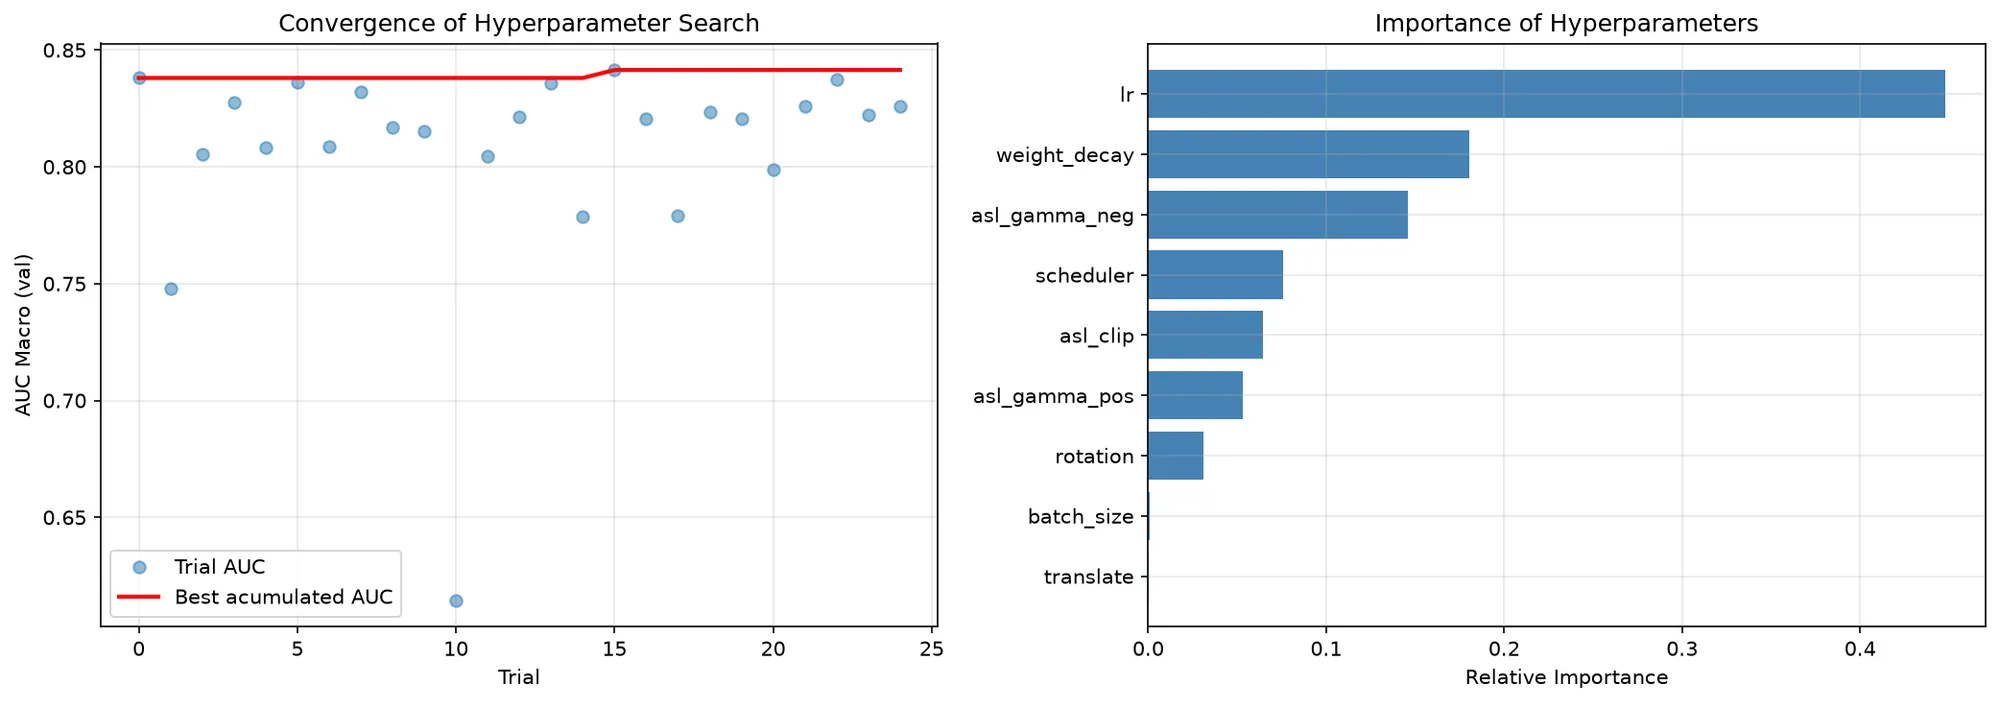
- Búsqueda de hiperparámetrosOptuna: 25 ensayos con TPE y poda por medianaAUC val. 0,841
- EntrenamientoDenseNet-121 + ASL + aumento de datos, con early stoppingmáx. 30 épocas
- Calibración de umbralesUn umbral por patología, elegido en validación entre 6 estrategias
- Evaluación en testAUC, F1, Hamming, exactitud exacta y precisión equilibrada
- ExplicabilidadGrad-CAM++ sobre el último bloque densodenseblock4
Optuna ajusta a la vez la tasa de aprendizaje, el tamaño de lote, el weight decay, el planificador, los tres parámetros de la ASL y la intensidad de los aumentos.
 Ver imagen ampliada
La pérdida asimétrica es el núcleo del entrenamiento. Usa un exponente γ distinto para positivos y negativos y desplaza las probabilidades de los negativos para descartar los más fáciles:
# src/models/losses.py — AsymmetricLoss.forward (simplificado)
xs_pos = torch.sigmoid(x)
# Desplaza los negativos: los muy fáciles dejan de contar
xs_neg = (1 - xs_pos + self.clip).clamp(max=1)
loss = y * torch.log(xs_pos.clamp(min=self.eps)) \
     + (1 - y) * torch.log(xs_neg.clamp(min=self.eps))
pt = xs_pos * y + xs_neg * (1 - y)
# Exponente γ distinto para positivos y negativos
gamma = self.gamma_pos * y + self.gamma_neg * (1 - y)
loss *= torch.pow(1 - pt, gamma)
return -loss.mean()
Resultados
- ResNet-50 a 128 px0,807
- Línea base: ResNet-50 a 224 px0,825
- BCE ponderada0,817
- Focal loss0,823
- Asymmetric loss0,826
- DenseNet-1210,827
- Aumento de datos0,837
- Codificador congelado0,736
- Pipeline final (DenseNet-121 + ASL + aumentos + Optuna)0,830
Escala de 0,70 a 0,85
| Métrica en test | Línea base | Pipeline final |
|---|---|---|
| AUC-ROC macro | 0,8245 | 0,8296 |
| F1 macro | 0,2721 | 0,3075 |
| Exactitud exacta (todas las etiquetas bien) | 0,3570 | 0,3901 |
| Hamming score | 0,9102 | 0,9139 |
| Precisión equilibrada media | 0,6513 | 0,6577 |
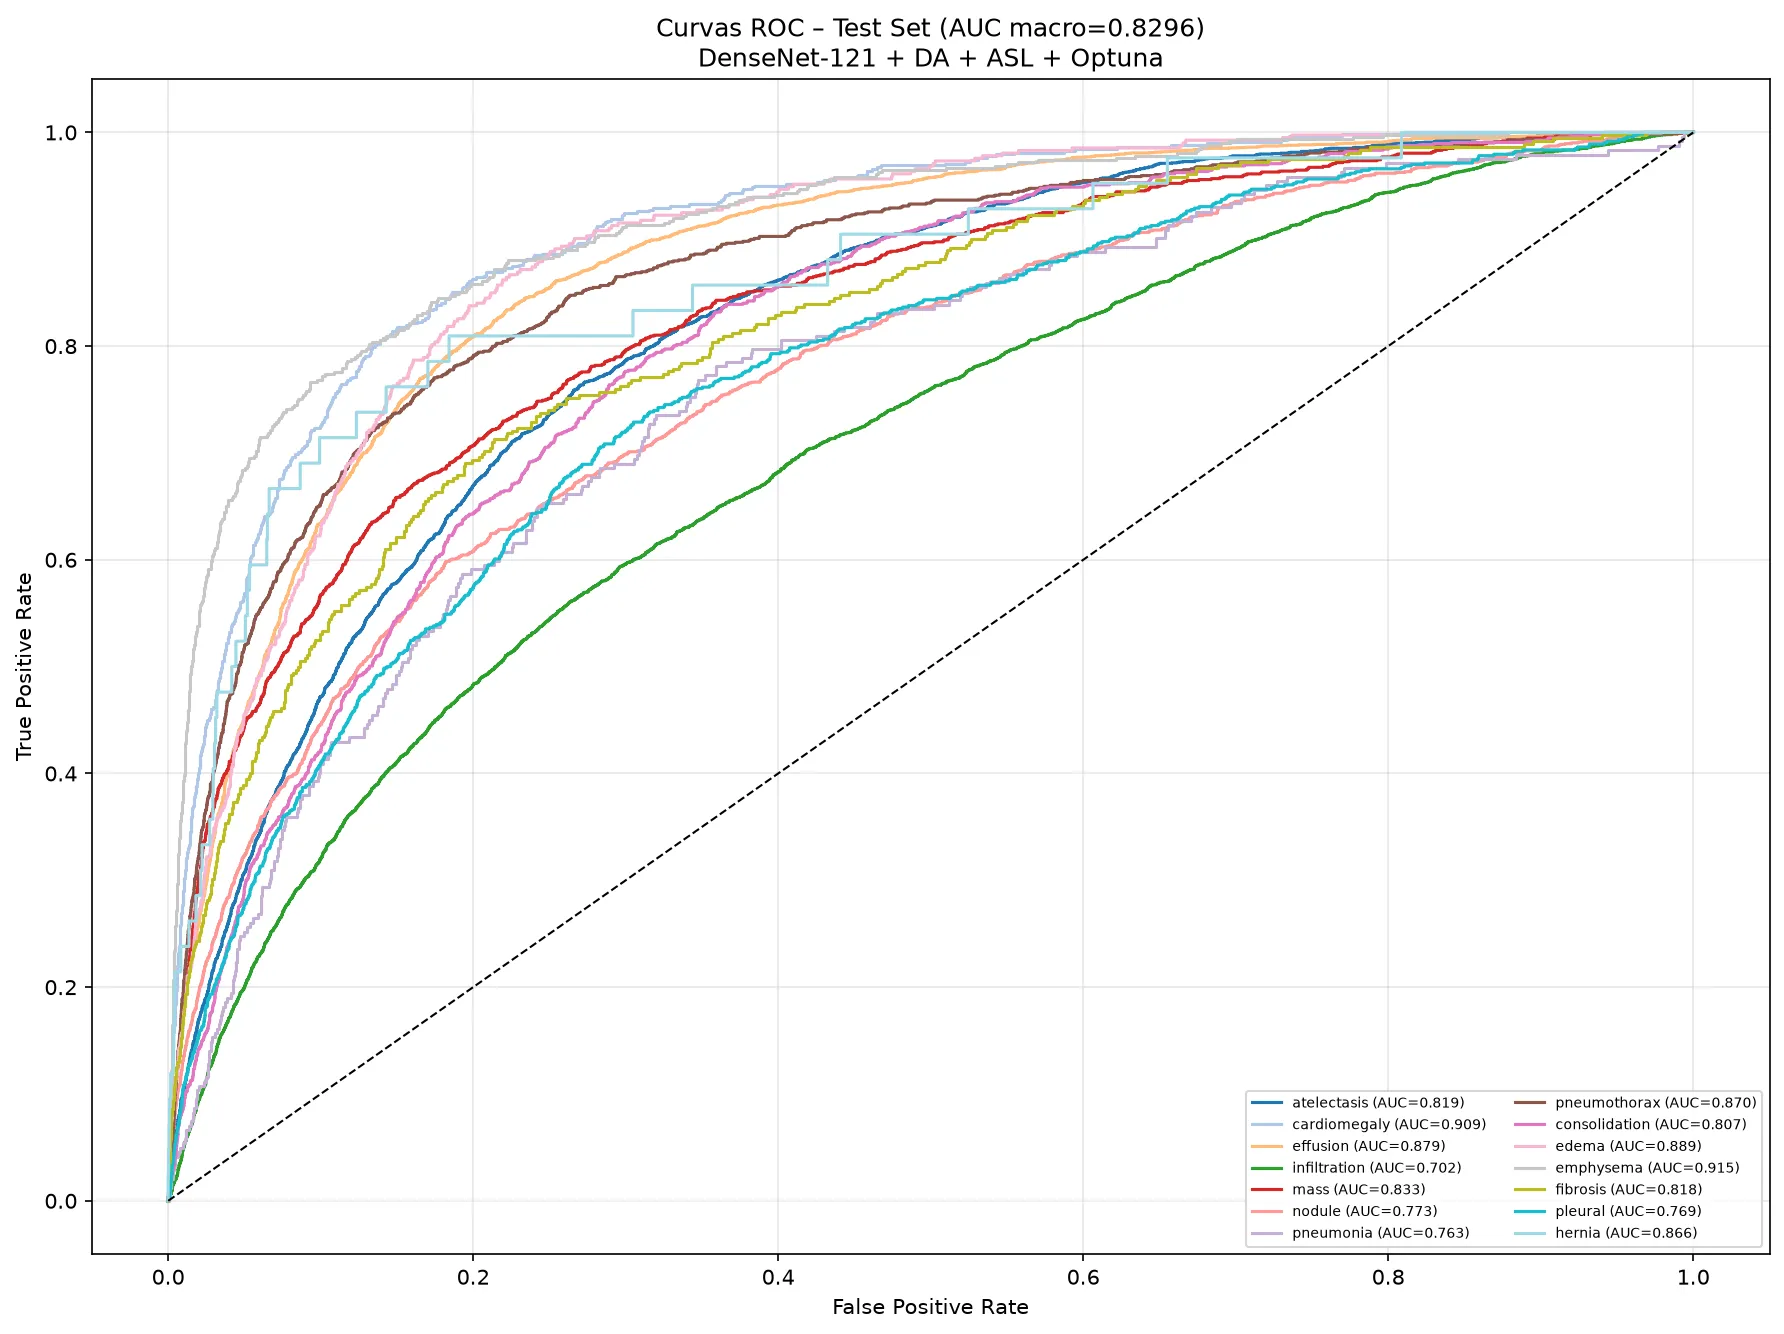
El pipeline final mejora a la línea base sobre todo en F1 macro (+0,035) y en imágenes con todas las etiquetas correctas (+3,3 puntos). En AUC, las mejores variantes están a centésimas unas de otras, lo mismo que separa dos ejecuciones del propio pipeline final (0,8296 en la del repositorio y 0,8361 en la de la presentación). Con esa variación, el valor del pipeline no está en una décima más: está en que todo el proceso es reproducible con un comando.
El resultado está a la altura del estado del arte en ChestMNIST: supera a las referencias oficiales de MedMNIST v2 (ResNet-50 a 224 px: 0,773) y se acerca a lo publicado con modelos fundacionales (0,835).
Elegir el umbral es una decisión clínica
Con 14 salidas probabilísticas hay que decidir a partir de qué valor se da cada patología por presente. El código compara seis estrategias en validación y elige la de mayor F1 macro:
| Estrategia (validación) | F1 macro | Casos no detectados | Falsas alarmas |
|---|---|---|---|
| Youden por patología | 0,229 | 2.229 | 31.555 |
| Umbral global óptimo (0,38) | 0,269 | 3.570 | 11.359 |
| F1 por patología (elegida) | 0,314 | 4.056 | 9.376 |
| Umbral fijo 0,5 | 0,204 | 5.943 | 2.416 |
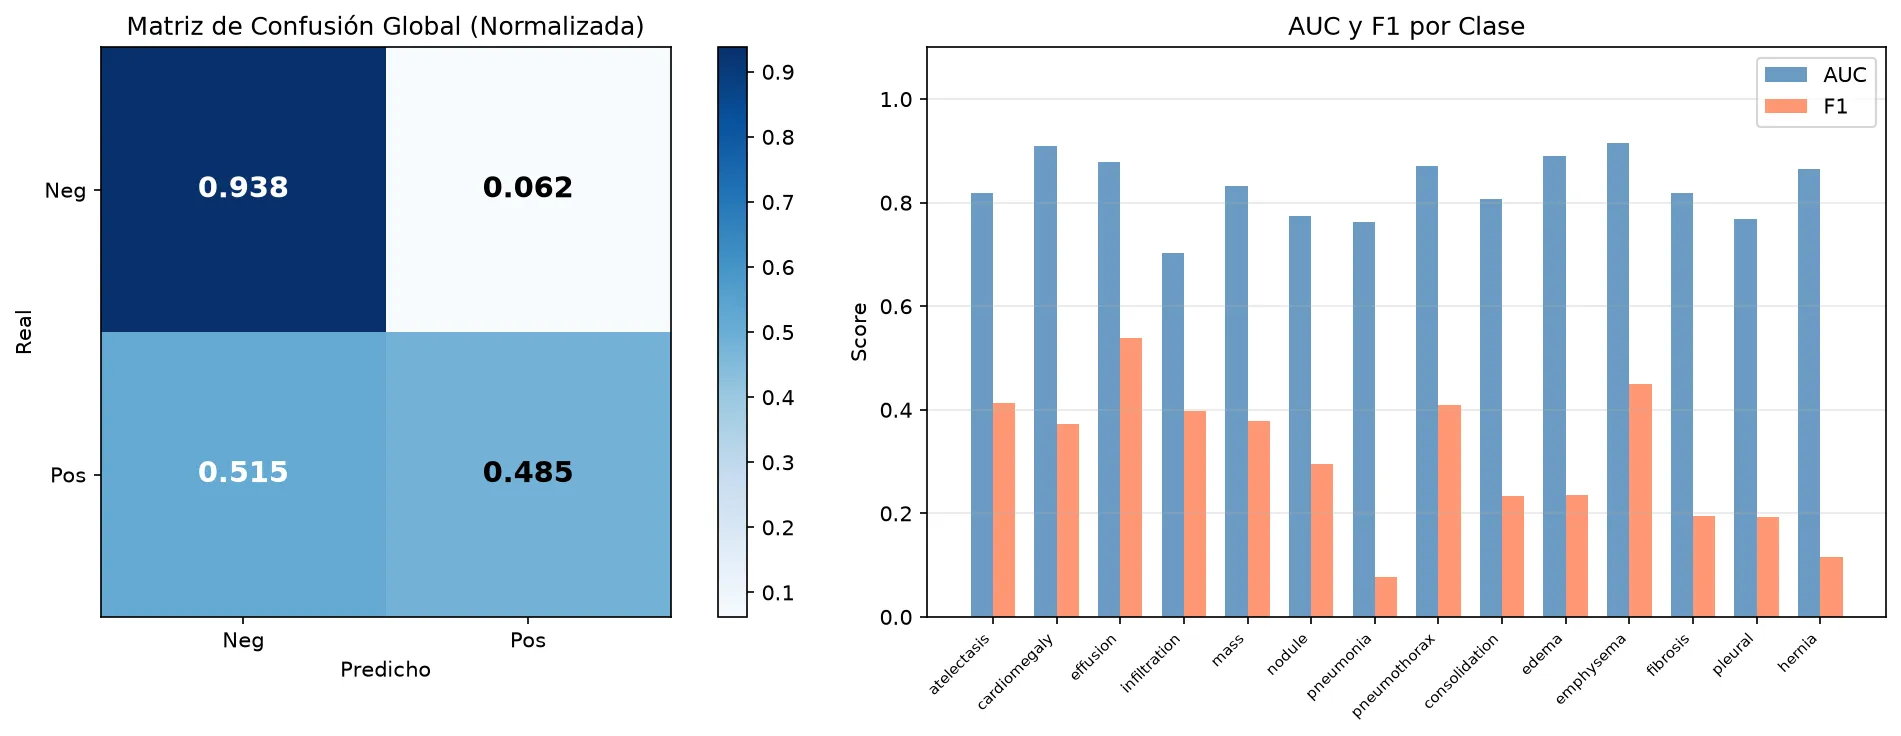
La tabla muestra el compromiso: el umbral fijo de 0,5 apenas da falsas alarmas, pero no detecta casi 6.000 hallazgos. En un cribado, donde un caso perdido cuesta más que una revisión extra, convendría Youden aunque baje el F1. Es una decisión que se toma con el equipo clínico, no un valor por defecto.
 Ver imagen ampliada
 Ver imagen ampliada
Qué mira el modelo
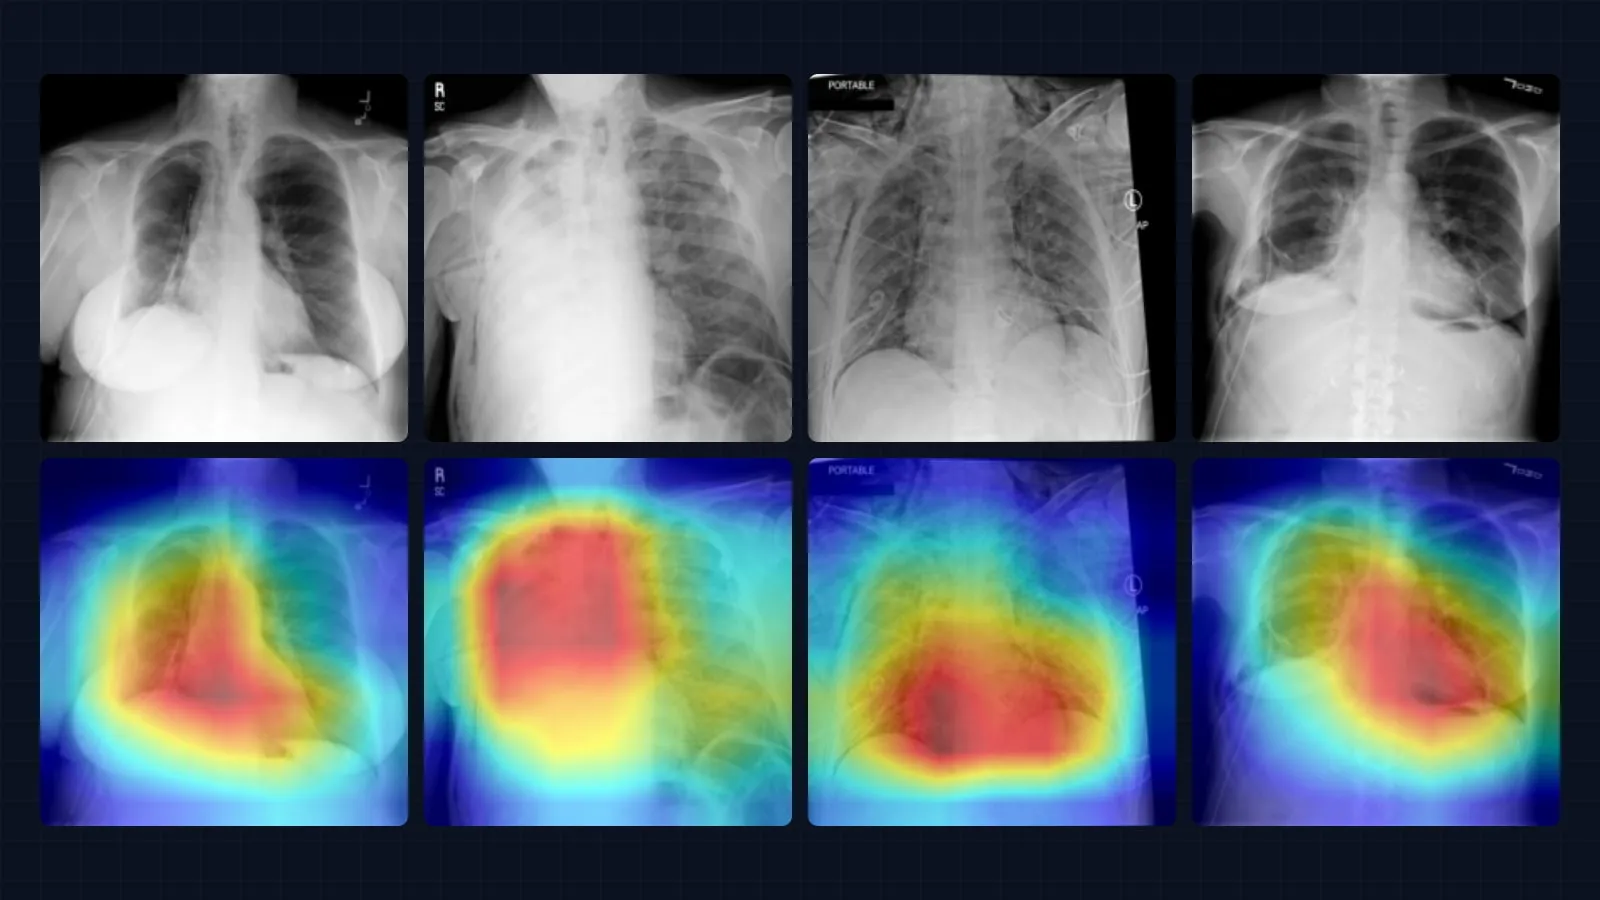
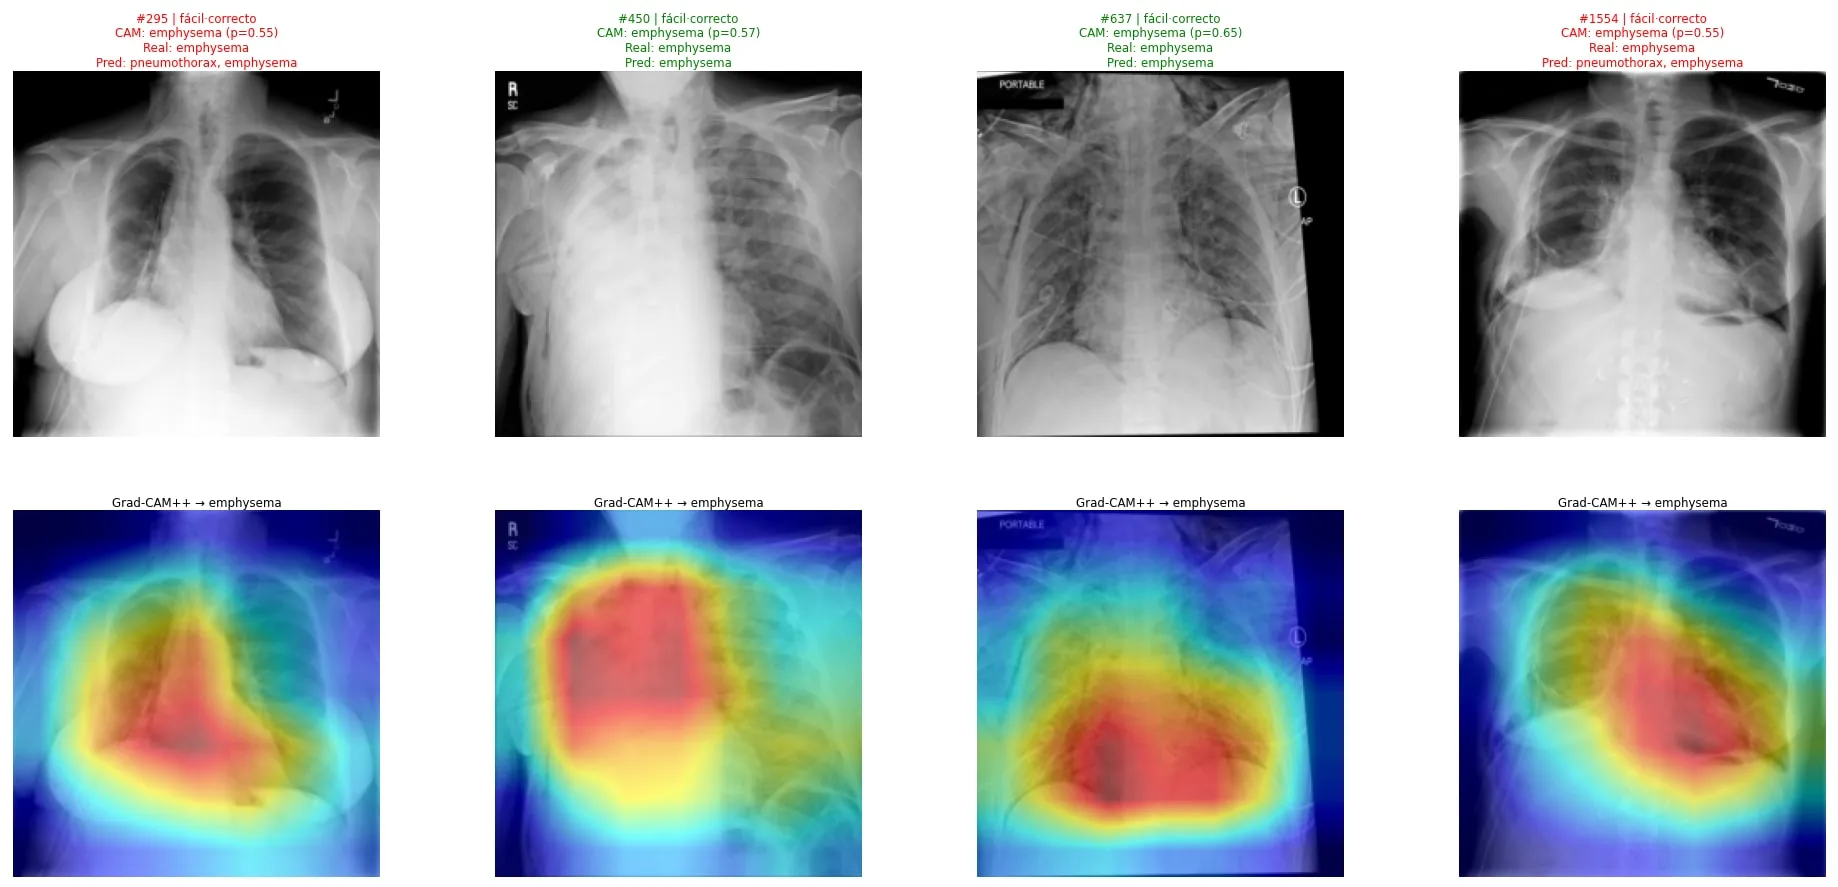
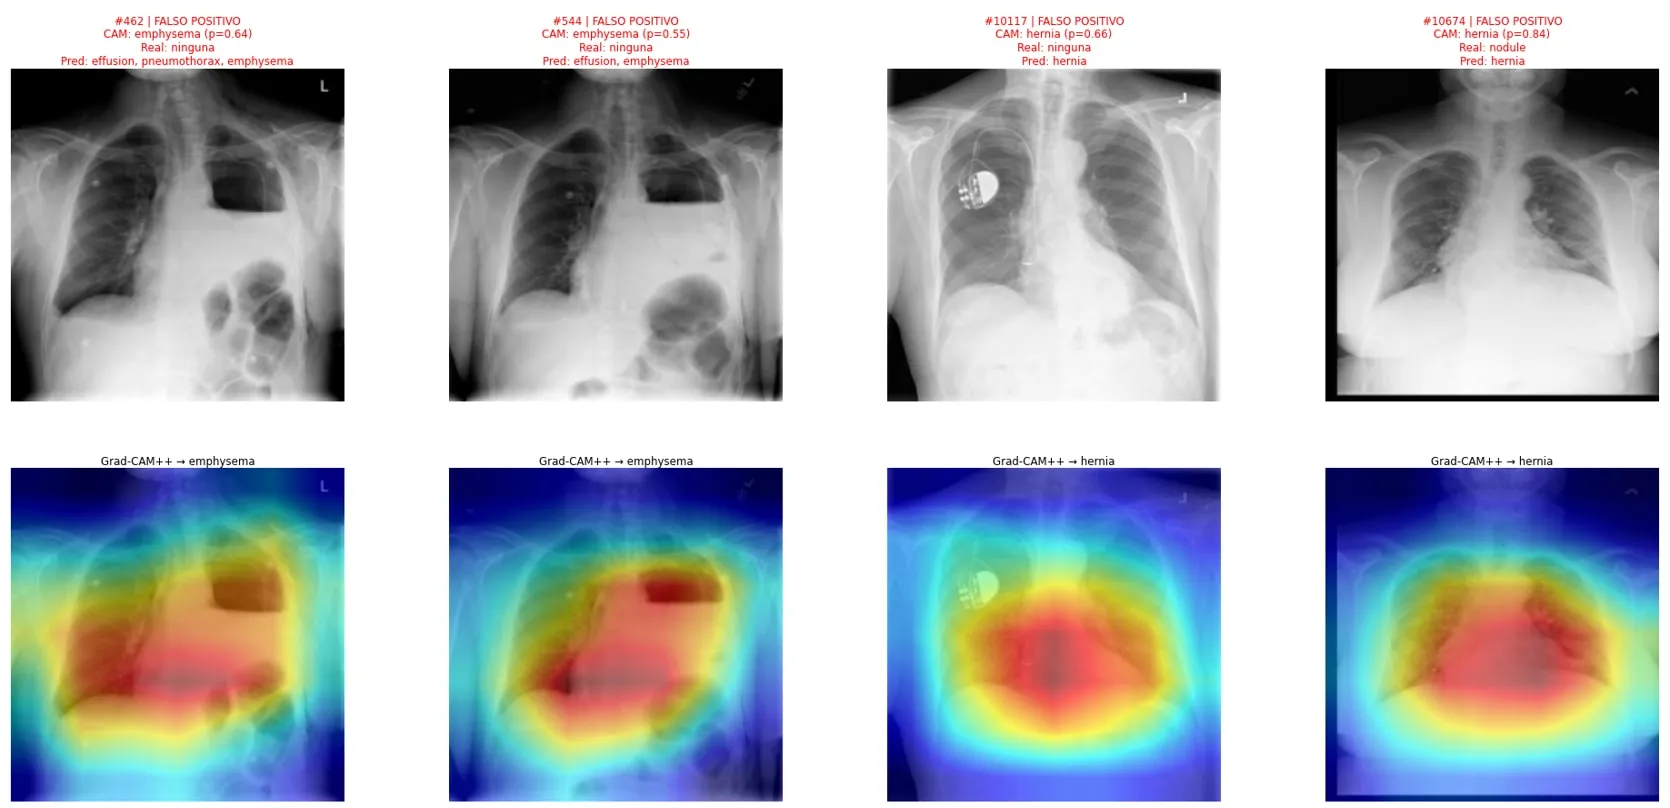
Grad-CAM++ calcula, para una patología, qué zonas de la imagen han pesado más en la predicción. Sirve para comprobar que el modelo se fija en los pulmones y no en marcas, cables o texto de la placa.
 Ver imagen ampliada
 Ver imagen ampliada
Limitaciones:
- El F1 de las clases raras sigue siendo bajo (neumonía 0,08; hernia 0,11): con tan pocos positivos, cualquier umbral produce muchas falsas alarmas.
- Cada variante se entrenó una vez, con una partición y una semilla. Las diferencias de centésimas no son concluyentes.
- Las etiquetas de ChestX-ray14 se extrajeron automáticamente de los informes radiológicos y tienen ruido.
- A 224 px queda por debajo de modelos entrenados con la resolución original de NIH ChestX-ray14 (p. ej., 0,853 de AUC con una DenseNet-121).
Evidencias
- Repositorio con el código, los logs de cada ejecución y las métricas finales en JSON (
results/). - Presentación con el estudio completo: estado del arte, ablaciones y explicabilidad.
- Para reproducirlo:
pip install -r requirements.txt && pip install -e .y despuéspython -m src.pipelines.pipeline_final.
Aplicación profesional
- Clasificadores multietiqueta con clases desbalanceadas: imagen médica, inspección industrial con varios defectos por pieza o etiquetado de contenido.
- Fijar umbrales según el coste real de cada tipo de error, en lugar de usar 0,5 por defecto.
- Auditar con mapas de explicabilidad un modelo de visión antes de ponerlo en manos de usuarios.
Otros proyectos
Ver todos los proyectos
Imagen médica
Segmentación de melanoma con U-Net implementadas desde cero en PyTorch
Dos U-Net programadas desde cero para delimitar lesiones de piel: una entrenada desde cero y otra con un codificador ResNet-50 preentrenado y congelado.
Visión por computador
Estudio de ablación en MNIST y CIFAR-10: 99,47 % y 93,87 % de exactitud
Dos estudios de ablación que miden cuánto aporta cada pieza hasta superar el 99,4 % en MNIST sin convoluciones y el 92 % en CIFAR-10.