IA generativa · 2026
Transcripción y resumen local de vídeos con Whisper y un LLM cuantizado
Aplicación web que transcribe y resume vídeos, con Whisper y un LLM de 14B cuantizado, todo en local y sin APIs externas.
- procesamiento local, sin APIs externas
- 100 %
- parámetros del LLM, cuantizado a 4 bits
- 14B
- LLM intercambiables desde la interfaz
- 2
- tamaños de Whisper seleccionables
- 3
Problema
Ver una clase, una charla o una entrevista de una hora para saber si interesa lleva, precisamente, una hora. Los servicios que resumen vídeos envían el audio a APIs de terceros, con su coste por uso y la duda de qué pasa con el contenido cuando es privado: una reunión interna, una clase grabada o una entrevista con datos personales.
El objetivo de este proyecto es una aplicación que realiza todo el proceso en local, en una GPU propia: recibir un vídeo y devolver un resumen breve en español junto con la transcripción completa.
Mi contribución
Proyecto en grupo, mi parte fue:
- Modelos configurables desde la interfaz. Organicé el backend para que el modelo de Whisper, el LLM y su configuración lleguen con cada petición desde el frontend. Optimicé el uso de GPU, controlando la carga de modelos en caso de cambiar de una petición a otra.
- Control de la salida del LLM. Añadí control de tokens de salida, formateando el resultado al esperado.
- Panel de ajustes en el frontend para elegir los modelos y los parámetros de generación, y gestión de errores con trazas en el backend.
Enfoque técnico
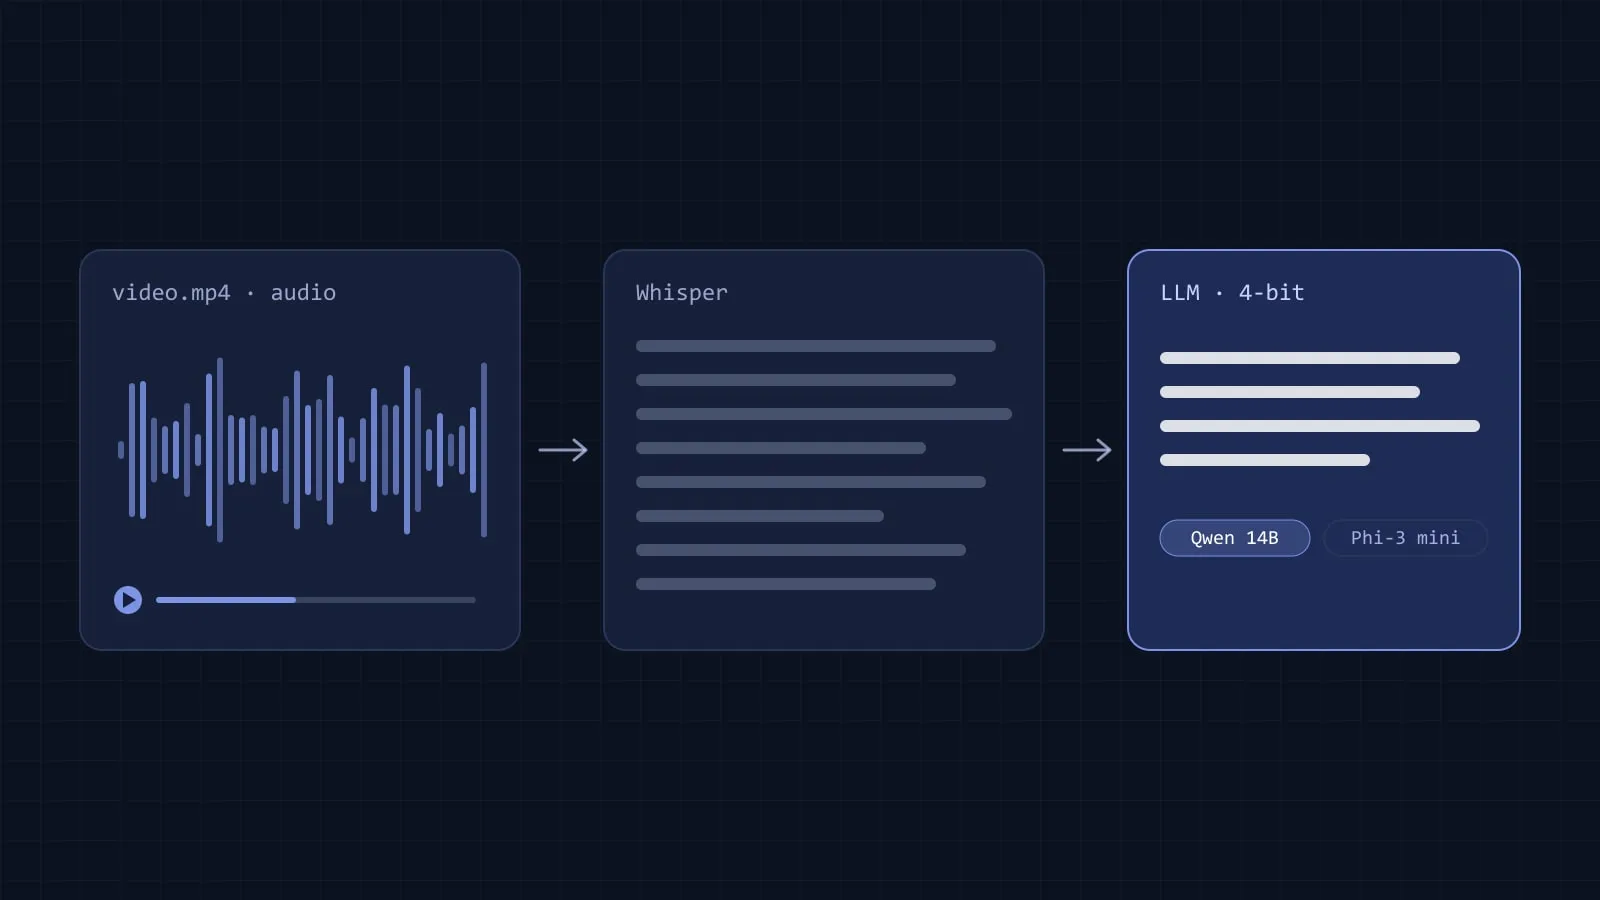
- Vídeo o audioSe arrastra al chat o se graba desde el navegador
- FFmpegExtrae el audio: MP3 mono a 16 kHz
- WhisperTranscribe en localbase · small · medium
- LLM en 4 bitsResume en español en un máximo de cinco frasesQwen 1.5‑14B · Phi‑3 mini
- RespuestaTranscripción completa
Un modelo de 14B en una GPU de consumo. Qwen 1.5-14B-Chat ocupa unos 28 GB en media precisión (FP16). Cuantizado a 4 bits con NF4 (bitsandbytes), los pesos bajan a unos 7 GB y el cálculo se sigue haciendo en FP16:
# backend/main.py — carga del LLM (fragmento)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",             # NormalFloat de 4 bits
    bnb_4bit_compute_dtype=torch.float16,  # el cálculo, en FP16
)
model = AutoModelForCausalLM.from_pretrained(
    model_name, quantization_config=bnb_config, device_map="auto"
)
# Parar al cerrar el turno del asistente (formato ChatML)
terminators = [
    tokenizer.eos_token_id,
    tokenizer.convert_tokens_to_ids("<|im_end|>"),
    tokenizer.convert_tokens_to_ids("<|endoftext|>"),
]
Instrucciones al modelo. El prompt sigue el formato ChatML de Qwen y fija reglas explícitas: resumir solo en español, sin mezclar idiomas y en no más de cinco frases.
Resultados
- Aplicación completa y funcional: subida o grabación, transcripción, resumen y transcripción desplegable en una interfaz tipo chat con modo claro y oscuro.
- Todo el procesamiento ocurre en local; ningún audio ni texto sale del equipo.
- Modelos y parámetros de generación intercambiables desde la interfaz, sin reiniciar el servidor.
Evidencias
- Repositorio con el backend (FastAPI) y el frontend (React, TypeScript, Tailwind CSS), e instrucciones para ejecutarlo en local.
Aplicación profesional
- Resúmenes de reuniones, clases o entrevistas cuando el contenido no puede salir de la organización, por privacidad o por RGPD.
- Desplegar LLM de código abierto cuantizados en hardware propio, en lugar de depender de APIs de pago.
- Prototipos completos de IA (modelo, API e interfaz) para validar una idea con usuarios reales.
Otros proyectos
Ver todos los proyectos
Imagen médica
Clasificación multietiqueta de radiografías de tórax con DenseNet-121
Detección de 14 patologías a la vez en 112.000 radiografías de tórax, con pérdida asimétrica, umbrales calibrados por patología y Grad-CAM++ para auditar el modelo.
Imagen médica
Segmentación de melanoma con U-Net implementadas desde cero en PyTorch
Dos U-Net programadas desde cero para delimitar lesiones de piel: una entrenada desde cero y otra con un codificador ResNet-50 preentrenado y congelado.